VLM AI 辨識。用視覺語言模型判讀既有監視器畫面,電梯推車、貨物與保全櫃台情境自動告警。
- 01適用對象
- 02系統架構
- 03產品畫面
- 04核心功能
- 05功能規格
- 06常見問題
- 07聯絡陞釔
SynOne Vision VLM AI 辨識
Vision-Language Model · Existing Cameras · On-premise GPU
這一頁的完整內容(適用對象、系統架構、規格、常見問題)整理成一份 PDF,含公司聯絡資訊。
傳統影像分析只會框出「這裡有人」。SynOne Vision 用看得懂畫面、會用文字回答的視覺語言模型,判斷的是情境:電梯裡有幾個人、有沒有推車、推車上有沒有貨、該不該出現在這部電梯;保全是不是離開櫃台太久。用的是現有監視器,模型跑在案場自己的顯示卡上,沒有按次計費的雲端 API。
- 客梯與貨梯要分流的大樓
- 辦公大樓
- 商場
- 廠辦
客梯出現平板推車、手推車、大件貨物就告警,清潔推車等可設為放行;貨梯有人搭乘卻沒用推車也能提醒。
- 需要看住保全櫃台的管委會與物業公司
保全離開櫃台超過設定時間、夜班時段疑似睡覺超過設定時間,各自告警並附截圖;低頭看手機不算睡覺。
- 已經有監視系統、不想再買 AI 攝影機的案場
直接讀現有 IP 攝影機的 RTSP 串流,加一台有顯示卡的主機即可,判斷規則依案場需求調整。
判斷情境與告警規則由我們依案場需求設定與調整。鏡頭角度要能看到整個電梯車廂或櫃台。實際上線配置為 Windows 主機搭配 NVIDIA 8GB 顯示卡,模型約佔 5GB 顯示記憶體;其他硬體請先與我們確認。
先用很便宜的方式比對畫面有沒有變,有變才交給模型判斷;連續幾次答案一致才改變狀態,避免單張誤判。會告警的事件送進 SynOne 告警中心。
- 判斷情境,不只是框出物件
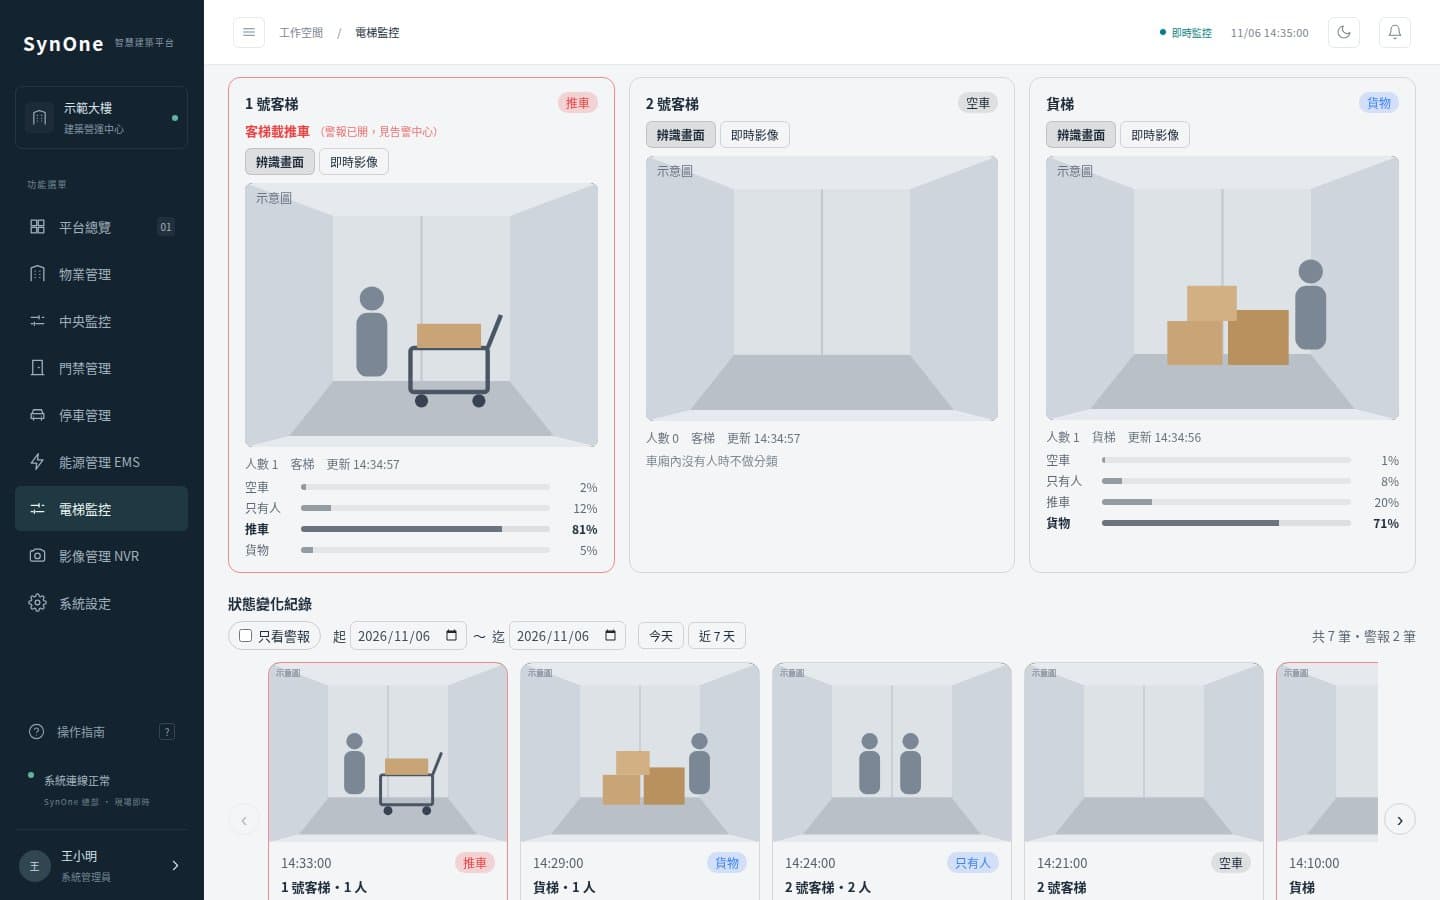
模型回答車廂內人數、有沒有推車、推車種類(平板、兩輪手推、摺疊拖車、清潔推車……)、有沒有載貨、有沒有大件貨物,並附一句中文描述;會忽略門外、梯廳與鏡面反射裡的人。
- 畫面沒變就不重問
先比對縮圖有沒有變化,有變才問模型;每部電梯最多每 2 秒一次,沒變化也定時重確認。顯示卡大部分時間處於待機。
- 多數決,避免單張誤判
連續幾次答案中多數一致才改變狀態;同一部電梯 30 分鐘內的重複偵測合併成一筆告警。
- 告警附截圖,處理留紀錄
告警在 SynOne 告警中心彈窗並發出警示音,附截圖與 AI 說明,按「確認已處理」會留下紀錄;狀態變化紀錄可依日期或「只看警報」篩選。
Vision 需要 SynOne 平台的攝影機串流與告警中心;判斷情境可依案場增加。
- 模型內容開源視覺語言模型(Qwen3-VL 4B),在案場顯示卡上執行備註沒有雲端 API 費用;影像不送雲端 AI。
- 電梯車廂內容人數、推車與種類、是否載貨、大件貨物;客梯載推車、貨梯未用推車告警備註每支攝影機可設定為客梯或貨梯;可放行的推車種類可設定。
- 保全櫃台內容離開櫃台超過設定分鐘、夜班時段疑似睡覺超過設定分鐘備註畫面裁切範圍、分鐘數、夜班時段可設定;啟用前請先告知保全人員。
- 輸出內容電梯頁 AI 面板(辨識畫面/即時影像切換、紅框標示)、告警中心、狀態變化紀錄與截圖備註辨識、電梯告警、櫃台告警三個開關分開,告警預設關閉。
- 實測配置內容Windows 主機、NVIDIA 8GB 顯示卡;模型約佔 5GB 顯示記憶體備註單張判斷約 1 秒內;攝影機多時依序排隊判斷。
| 項目 | 內容 | 備註 |
|---|---|---|
| 模型 | 開源視覺語言模型(Qwen3-VL 4B),在案場顯示卡上執行 | 沒有雲端 API 費用;影像不送雲端 AI。 |
| 電梯車廂 | 人數、推車與種類、是否載貨、大件貨物;客梯載推車、貨梯未用推車告警 | 每支攝影機可設定為客梯或貨梯;可放行的推車種類可設定。 |
| 保全櫃台 | 離開櫃台超過設定分鐘、夜班時段疑似睡覺超過設定分鐘 | 畫面裁切範圍、分鐘數、夜班時段可設定;啟用前請先告知保全人員。 |
| 輸出 | 電梯頁 AI 面板(辨識畫面/即時影像切換、紅框標示)、告警中心、狀態變化紀錄與截圖 | 辨識、電梯告警、櫃台告警三個開關分開,告警預設關閉。 |
| 實測配置 | Windows 主機、NVIDIA 8GB 顯示卡;模型約佔 5GB 顯示記憶體 | 單張判斷約 1 秒內;攝影機多時依序排隊判斷。 |
- 要換成 AI 攝影機嗎?
- 不用。直接讀現有 IP 攝影機的 RTSP 串流,只要鏡頭角度看得到整個電梯車廂或櫃台。另外需要一台有 NVIDIA 顯示卡的主機跑模型。
- 影像會上傳到雲端嗎?
- 影像不會送到任何雲端 AI 服務,模型在案場自己的顯示卡上執行。告警截圖存在案場主機,只有平台上有影像權限的帳號看得到。
- 可以辨識其他情境嗎?
- 視覺語言模型是用文字描述要判斷什麼,新情境不必重新訓練模型。目前上線的是電梯與保全櫃台;其他需求請告訴我們,由我們評估、設定判斷內容並在現場實測後再啟用。
- 準確度如何?
- 準確度跟鏡頭角度、光線、案場情境有關,我們不提供一個通用的百分比。導入時會先開辨識、告警關閉,在現場實際測試各種情境,確認判斷符合需求再開啟告警。
每一套都可以單獨購買;裝在同一個 SynOne 平台上時,共用帳號、告警,以及同一份人員、門與設備資料。
授權說明
本軟體以買斷授權方式提供,一份授權限一個案場、一台主機,並以數位簽章授權檔綁定主機硬體。禁止複製安裝至其他主機或案場、轉售出借、逆向工程或規避授權驗證;違者依著作權法追究民事及刑事責任。完整軟體授權條款 →
- 公司名稱
- 陞釔有限公司 SHENGYI CO., LTD.
- 統一編號
- 62222816
- 公司地址
- 台灣 新北市新店區安民街70巷3號7樓
- 電話
- 02-8666-3131
- contact@shengyiltd.com
- 服務時間
- 週一至週五 09:00–18:00
https://shengyiltd.com